Fundamentos de IA: Modelos densos vs MoE
O artigo anterior tratou de NLP e NLU, o campo conceitual por trás dos modelos de linguagem. Este último fecha a série voltando para a arquitetura: a diferença entre modelos densos e MoE, quais parâmetros são de fato ativados a cada token e por que isso muda a conta de custo e de memória, assunto que já tinha aparecido no artigo sobre quantização e uso local.
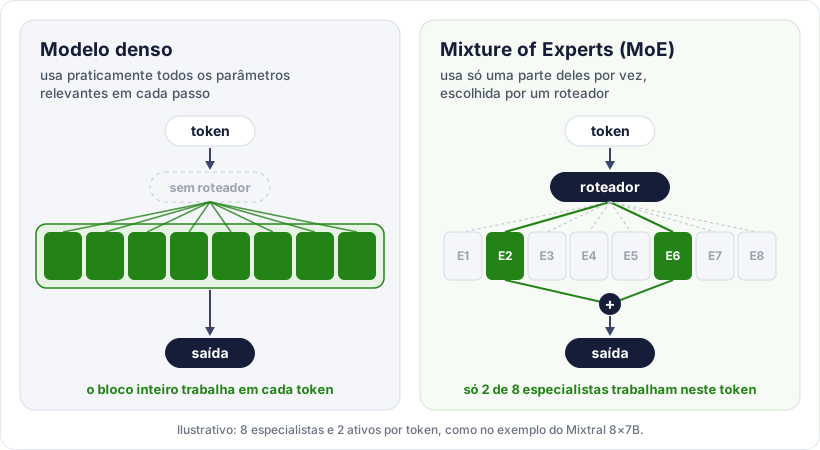
A diferença central é esta: modelo denso usa praticamente todos os parâmetros relevantes em cada passo de processamento, enquanto Mixture of Experts (MoE) usa só uma parte deles por vez, escolhida por um roteador. Isso faz o MoE parecer um “time de especialistas”, enquanto o denso parece um “bloco único” que trabalha inteiro o tempo todo.
Modelos densos são os mais “diretos”: para cada token processado, o modelo ativa o caminho completo da rede, então o custo computacional acompanha mais diretamente o tamanho do modelo. Já MoE introduz computação condicional, em que um roteador escolhe apenas alguns especialistas para cada token, permitindo aumentar muito o número total de parâmetros sem ativar tudo ao mesmo tempo.
Na prática, isso significa que modelos MoE podem ter enorme capacidade total com custo de inferência mais controlado do que um modelo denso do mesmo tamanho total, embora tragam desafios extras de roteamento, balanceamento e implementação.
O que é modelo denso?
Um modelo denso é o tipo mais tradicional de rede neural em que todas as partes principais daquela camada ou bloco participam do cálculo para cada entrada. Em LLMs, isso normalmente significa que cada token passa pelo mesmo conjunto completo de camadas e sub-redes relevantes.
A consequência prática é simples: o comportamento é mais previsível e a implementação costuma ser mais direta, mas o custo cresce junto com o tamanho do modelo. Se o modelo é muito grande, cada token fica caro de processar porque “todo o cérebro” entra em ação o tempo todo.
O que é MoE?
Mixture of Experts (MoE), ou mistura de especialistas, é uma arquitetura em que parte da rede é dividida em vários “experts”, e um mecanismo de gating ou router decide quais especialistas devem ser ativados para cada entrada ou token.
O ponto principal é que o modelo pode ter muitos parâmetros no total, mas usar só uma fração deles em cada passo. Isso cria uma arquitetura esparsa, porque nem tudo é ativado sempre.
Como o MoE trabalha
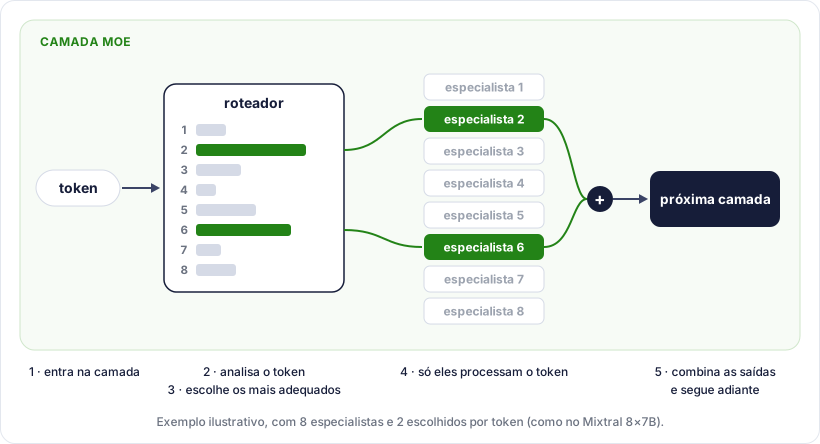
O fluxo simplificado do MoE costuma ser assim:
- O token entra na camada.
- Um roteador analisa esse token.
- O roteador escolhe os especialistas mais adequados.
- Só esses especialistas processam o token.
- As saídas deles são combinadas e seguem para a próxima camada.
A IBM cita, por exemplo, o caso do Mixtral 8×7B, em que há 8 especialistas por camada e, para cada token, o roteador seleciona 2 especialistas para processar aquele dado. Isso mostra bem a ideia de “muitos parâmetros disponíveis, poucos ativos por vez”.
Analogia simples
Uma boa analogia é esta:
- Modelo denso: um engenheiro generalista faz todo o trabalho sozinho, em todas as tarefas.
- MoE: um gerente recebe a tarefa e encaminha partes do problema para especialistas diferentes.
Isso ajuda a entender por que o MoE pode ser eficiente: você não mobiliza a empresa inteira para cada microtarefa.
Diferença principal
A diferença mais importante entre eles está em quais parâmetros são ativados por token. Em modelos densos, todos os parâmetros relevantes daquela rota são usados a cada processamento; em MoE, só o roteador e alguns experts são ativados.
Isso leva a uma distinção prática:
- Denso: mais simples de entender e operar.
- MoE: mais eficiente para escalar capacidade total sem ativar tudo.
Denso vs MoE na prática
| Aspecto | Modelo denso | Modelo MoE |
|---|---|---|
| Ativação por token | Usa o caminho completo da rede para cada token. | Ativa só alguns especialistas por token. |
| Tipo de computação | Mais uniforme e direta. | Condicional e esparsa. |
| Escala de parâmetros | Cresce com custo alto por token. | Pode crescer muito sem ativar tudo. |
| Implementação | Mais simples. | Mais complexa por causa de roteamento e balanceamento. |
| Eficiência | Boa em cenários menores e diretos. | Pode ser vantajosa em grande escala. |
O que significa “parâmetros totais” e “parâmetros ativos”
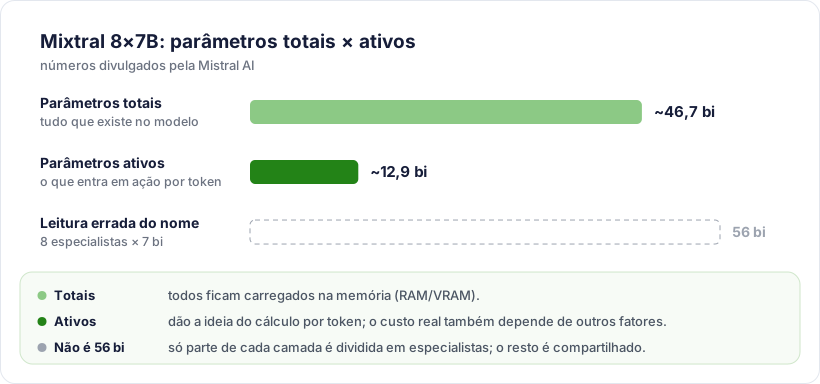
Em MoE, uma confusão comum é achar que o número total de parâmetros equivale ao custo real por token. Não equivale, porque o modelo pode ter muitos parâmetros no total, mas ativar só uma parte deles durante a inferência.
Então você vai ver duas ideias diferentes:
- Parâmetros totais: tudo que existe no modelo.
- Parâmetros ativos: o que realmente entra em ação para um token específico.
Essa distinção é uma das chaves para não interpretar errado nomes como “8×7B” ou modelos gigantescos com custo de uso menor do que parece à primeira vista.
Vantagens do modelo denso
Os modelos densos têm algumas vantagens claras:
- Arquitetura mais simples de treinar e servir.
- Comportamento mais uniforme, sem precisar resolver roteamento entre experts.
- Menos complexidade operacional em comparação com MoE.
Por isso, eles continuam muito relevantes, especialmente em cenários em que simplicidade, previsibilidade e compatibilidade importam mais do que escalar capacidade total extrema.
Vantagens do MoE
Os MoE se destacam quando você quer aumentar muito a capacidade total do modelo sem pagar o custo de ativar tudo em cada passo. A IBM destaca justamente isso: impor escassez na ativação permite aumentar capacidade mantendo custos computacionais mais próximos de níveis administráveis.
Além disso, MoE pode favorecer especialização interna entre experts e melhorar eficiência em larga escala. Isso não significa automaticamente “mais inteligente em tudo”, mas significa uma forma diferente e poderosa de escalar modelos.
Desvantagens do MoE
O MoE traz complexidade extra. Você precisa de um roteador bom, precisa evitar que poucos experts recebam quase todo o tráfego e precisa lidar com balanceamento de carga entre especialistas.
Além disso, custos reais de inferência não podem ser estimados só olhando “parâmetros ativos”; também entram fatores como número de camadas, comunicação entre máquinas e detalhes de implementação. A Epoch AI chama atenção exatamente para isso ao comparar MoE e modelos densos em inferência.
MoE é sempre melhor?
Não. MoE não substitui completamente modelos densos; ele é uma estratégia arquitetural diferente com trade-offs. MoEs podem ser mais eficientes do que modelos densos com o mesmo total de parâmetros, mas isso não quer dizer que sejam melhores do que um modelo denso bem ajustado com número semelhante de parâmetros ativos.
Então a pergunta certa não é “qual é superior em absoluto?”, mas sim “qual entrega melhor equilíbrio entre qualidade, custo, latência e simplicidade no meu caso?”.
Outros tipos que vale conhecer
Além de denso e MoE, existem outros rótulos e famílias que você provavelmente vai encontrar:
- Modelos esparsos (sparse): categoria mais ampla em que nem todos os parâmetros são ativados sempre; MoE é um exemplo importante disso.
- Switch Transformer: uma variação de MoE em que o roteador normalmente escolhe um único expert por token, simplificando parte da computação.
- Ensemble: combinação de vários modelos diferentes, mas isso não é a mesma coisa que MoE; a própria Ultralytics destaca que esses conceitos são confundidos com frequência.
- Modelos híbridos: arquiteturas que mantêm partes densas e partes esparsas, ou combinam mecanismos especializados em só alguns blocos.
Esses nomes importam porque mostram que “arquitetura de modelo” não é uma coisa única. O mercado e a pesquisa testam várias formas de distribuir capacidade e computação.
Dense, sparse e ensemble
Vale separar bem esses três termos:
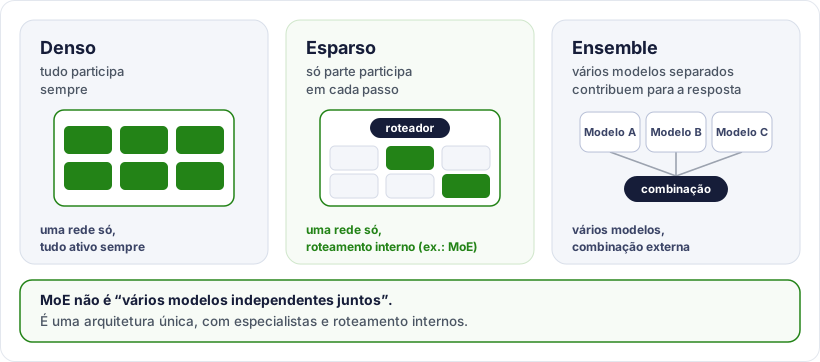
- Denso: tudo participa sempre.
- Esparso: só parte participa em cada passo.
- Ensemble: vários modelos separados contribuem para a resposta final, normalmente como combinação externa, não como uma única rede roteada internamente.
Essa distinção evita uma confusão comum: MoE não é simplesmente “vários modelos independentes juntos”; ele é uma arquitetura única com especialistas e roteamento internos.
Como pensar nisso de forma prática
Se você estiver olhando um modelo para uso real, pense assim:
- Denso: mais fácil de raciocinar sobre custo e comportamento.
- MoE: pode entregar muita capacidade com inferência mais econômica do que o tamanho total sugeriria.
- Sparse em geral: ideia de ativar só o necessário.
Para uso local, isso é especialmente importante porque o nome do modelo pode enganar. Um modelo MoE com muitos parâmetros totais não necessariamente tem o mesmo custo por token que um modelo denso do mesmo número total de parâmetros, mas também não é “de graça” em memória e infraestrutura.
Resumo Rápido:
Uma regra simples para guardar:
- Denso = um modelo grande que trabalha inteiro em toda entrada.
- MoE = vários especialistas, mas só alguns trabalham por entrada.
- Sparse = nome geral para arquiteturas que ativam só parte da rede.