Fundamentos de IA: Prompt, alucinação e agentes
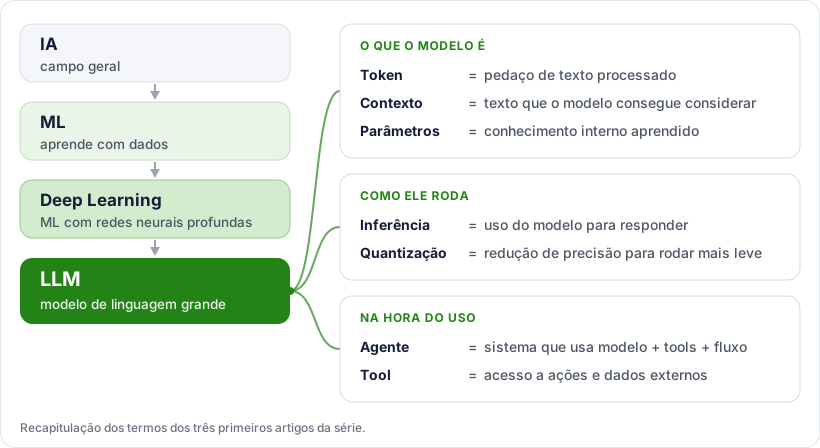
Até aqui vimos o que é um LLM, do que ele é feito e como ele é treinado e executado. Este artigo trata do que acontece na hora do uso: como o prompt influencia a resposta, por que o modelo alucina e como agentes e tools resolvem parte desse problema, indo além de só gerar texto. No final tem um mapa mental que recapitula os termos dos três primeiros artigos.
O que é prompt?
Prompt é a instrução ou entrada enviada ao modelo. Pode ser uma pergunta, um comando, um trecho de código, um documento ou tudo isso junto.
A qualidade da resposta depende bastante do prompt, porque o modelo usa esse texto como contexto para decidir a continuação mais adequada. Um prompt claro reduz ambiguidades e tende a melhorar o resultado.
A Alucinação acontece quando o modelo responde com algo que parece convincente, mas está incorreto, inventado ou não sustentado por dados reais.
Isso acontece porque o LLM é bom em gerar linguagem plausível, não em garantir verdade por conta própria. Por isso, para tarefas reais, muitas soluções usam ferramentas externas, busca, bases privadas ou validação humana.
O que é um agente de IA?
Um agente de IA é um sistema que usa IA para perseguir um objetivo e executar tarefas em várias etapas. Em vez de apenas responder uma pergunta, ele pode planejar, dividir o problema, usar ferramentas, consultar informações externas e decidir o próximo passo.
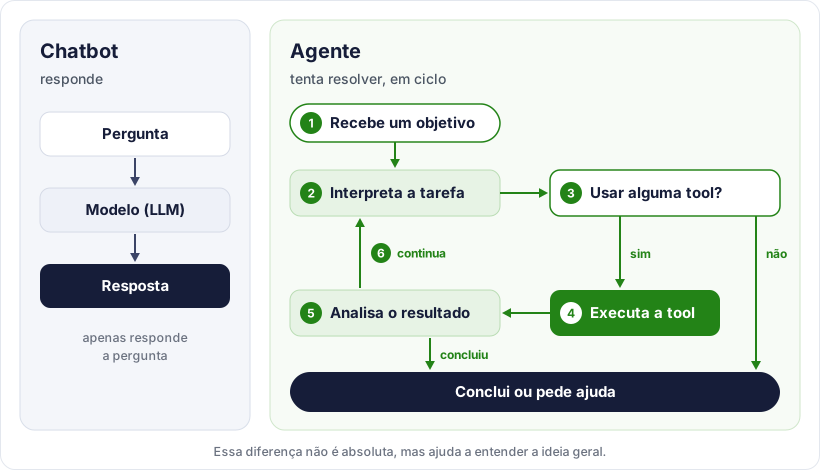
Em termos simples: um chatbot responde; um agente tenta resolver. Essa diferença não é absoluta, mas ajuda a entender a ideia geral.
Como agentes funcionam:
De forma simplificada, um agente costuma operar em ciclo:
- Recebe um objetivo.
- Interpreta a tarefa.
- Decide se precisa usar alguma tool.
- Executa a tool.
- Analisa o resultado.
- Continua até concluir ou pedir ajuda.
Nem todo agente é super autônomo. Alguns só fazem uma ou duas chamadas externas; outros montam fluxos maiores com planejamento, execução e reavaliação.
Toolcall
Tool é uma função, recurso ou integração externa que o agente pode usar para fazer algo que o modelo sozinho não consegue fazer diretamente. Exemplos comuns são busca na web, consulta em banco de dados, chamada de API, leitura de arquivos e envio de e-mails.
Isso é importante porque um LLM puro só gera texto. Para buscar informação atualizada, acessar um sistema ou disparar uma ação concreta, ele precisa de tools.
Tipos comuns de tool
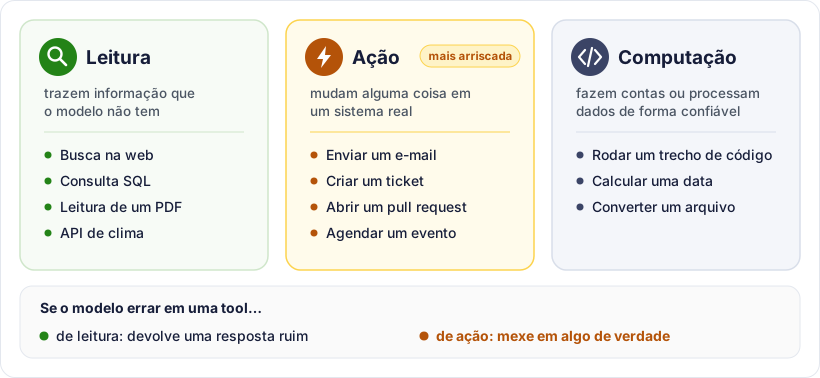
Ajuda pensar em três grupos:
- Leitura: trazem informação que o modelo não tem. Busca na web, consulta SQL, leitura de um PDF, chamada a uma API de clima.
- Ação: mudam alguma coisa em um sistema real. Enviar um e-mail, criar um ticket, abrir um pull request, agendar um evento.
- Computação: fazem contas ou processam dados de forma confiável. Rodar um trecho de código, calcular uma data, converter um arquivo.
A separação importa porque tool de ação é mais arriscada. Se o modelo errar em uma tool de leitura, ele devolve uma resposta ruim; se errar em uma de ação, ele mexe em algo de verdade.
Um exemplo concreto
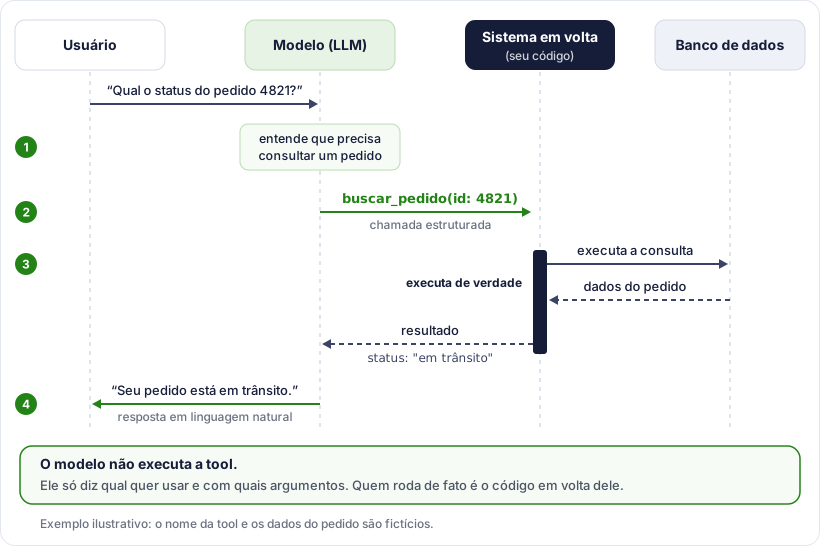
Pergunta: “Qual o status do pedido 4821?”
Um LLM sozinho não tem como responder. Ele não acessa o banco de dados e esse pedido nem existia quando ele foi treinado. Com uma tool, o fluxo fica assim:
- O modelo entende que precisa consultar um pedido.
- Ele emite uma chamada estruturada, algo como buscar_pedido(id: 4821).
- O sistema em volta executa essa chamada de verdade e devolve o resultado.
- O modelo lê esse resultado e escreve a resposta em linguagem natural.
Um detalhe que costuma passar batido: o modelo não executa a tool. Ele só diz qual quer usar e com quais argumentos. Quem roda de fato é o código em volta dele.
Como o modelo escolhe a tool
O modelo recebe uma lista das tools disponíveis, cada uma com nome, descrição e parâmetros. A escolha sai daí, então descrição vaga costuma gerar escolha errada.
- Ruim: buscar — “busca coisas”
- Bom: buscar_pedido — “consulta o status e a data de entrega de um pedido pelo número”
Quando a tool falha
Tool não é garantia de acerto. Ela pode retornar erro, vir vazia ou trazer dado desatualizado. Um agente bem feito precisa tratar isso: tentar de novo, usar outro caminho ou simplesmente dizer que não conseguiu. Sem esse tratamento, o modelo tende a preencher a lacuna inventando, que é exatamente a alucinação descrita mais acima.
Modelo x Agente
A diferença fica mais clara nesta tabela:
| Conceito | O que é |
|---|---|
| Modelo / LLM | O “cérebro” que entende entrada e gera texto por previsão de tokens. |
| Agente | O sistema que usa o modelo para atingir objetivos com etapas, regras e ferramentas. |
| Tool | A “mão” do agente para consultar, executar ou interagir com sistemas externos. |
Outros termos que vale conhecer
Alguns termos aparecem o tempo todo:
- NLP / PLN: processamento de linguagem natural, área focada em texto e linguagem.
- Rede neural: estrutura matemática usada para aprender padrões a partir de dados.
- Atenção: mecanismo que ajuda o modelo a dar peso às partes mais relevantes do contexto.
- Embedding: representação numérica de texto ou outros dados para capturar similaridade semântica. Isso é base para busca semântica e recuperação de contexto.
- Fine-tuning: ajuste adicional de um modelo já treinado para uma tarefa ou domínio específico.
- RAG: abordagem em que o sistema recupera informações externas antes de responder, reduzindo alucinação e trazendo dados mais atualizados.
Alguns desses termos têm artigo próprio nesta série. NLP / PLN é o tema do próximo artigo, que já está publicado. Embedding, fine-tuning e RAG ficam para artigos futuros, porque cada um rende uma explicação bem mais longa do que cabe aqui.
Mapa mental simples
Uma visão curta:
- IA = campo geral.
- ML = aprende com dados.
- Deep Learning = ML com redes neurais profundas.
- LLM = modelo de linguagem grande.
- Token = pedaço de texto processado.
- Contexto = texto que o modelo consegue considerar.
- Parâmetros = conhecimento interno aprendido.
- Inferência = uso do modelo para responder.
- Quantização = redução de precisão para rodar mais leve.
- Agente = sistema que usa modelo + tools + fluxo.
- Tool = acesso a ações e dados externos.