Fundamentos de IA: Treinamento, inferência e quantização
No artigo anterior a ideia foi entender o que é um LLM, como ele quebra texto em tokens e o que significam parâmetros e janela de contexto. Aqui o foco muda de “o que o modelo é” para “como ele roda”: as duas fases principais, treinamento e inferência, e a quantização, que é o que torna viável colocar modelos maiores em hardware limitado.
Como se dá o treinamento?
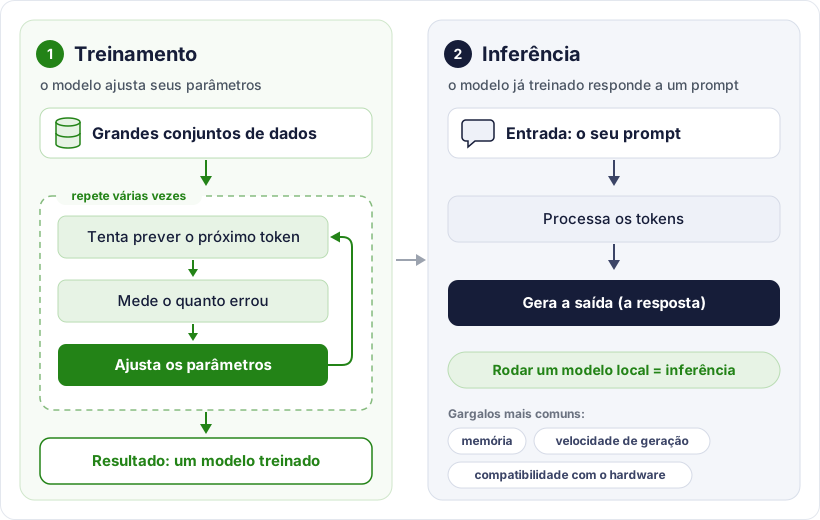
Treinamento é a fase em que o modelo ajusta seus parâmetros com base em grandes conjuntos de dados. Nessa etapa, ele aprende padrões de linguagem tentando melhorar sua capacidade de prever tokens corretamente.
Depois do treinamento, vem a inferência, que é quando você usa o modelo para gerar respostas. Quando você roda um modelo local no seu computador, normalmente você está fazendo inferência, não treinamento completo.
O que é inferência?
Inferência é a execução do modelo já treinado para responder a um prompt. É o momento em que ele pega a entrada, processa os tokens e gera a saída.
Se o seu foco é usar IA localmente, inferência é o termo mais importante no começo. O gargalo principal geralmente é memória, velocidade de geração e compatibilidade do modelo com seu hardware.
O que é quantização?
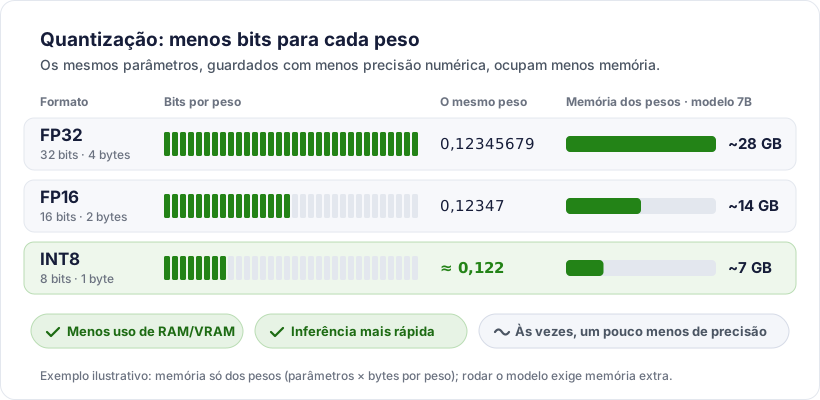
Quantização é uma técnica para reduzir a precisão numérica dos pesos e, às vezes, das ativações do modelo, trocando formatos mais pesados, como FP32 ou FP16, por formatos menores, como INT8. O objetivo é reduzir uso de memória e acelerar a inferência.
Traduzindo para a prática: quantização é uma forma de “compactar” o modelo para ele rodar melhor, especialmente localmente. Você perde um pouco de precisão em alguns casos, mas ganha muito em viabilidade, custo e velocidade.
Por que quantização importa localmente?
Sem quantização, muitos modelos ficam grandes demais para rodar com conforto em máquinas comuns. Com quantização, você consegue colocar modelos maiores em menos RAM ou VRAM e usar hardware mais barato ou mais limitado.
Então, quando você começar a testar modelos locais, provavelmente vai encontrar nomes e formatos ligados a isso. A ideia geral é sempre a mesma: tentar manter qualidade aceitável com menos custo computacional.